Segundo a Maritaca, o S5-nano, de 4B, lidera a média Native BR entre os modelos da tabela dela no modo Think.
Segundo a Maritaca, o S5-nano lidera a média Native BR no modo Think entre os modelos da tabela dela. E ele tem só 4B de parâmetros.
Destaque: S5-nano. A Maritaca publicou o modelo no Hugging Face com licença Apache 2.0. Tem dois modos: Think, que raciocina antes de responder, e Instruct, que responde direto. O contexto vai até 262.144 tokens. Há versões para vLLM, SGLang e llama.cpp. Os números de desempenho são da própria Maritaca. Para texto jurídico, comece com documentos públicos ou exemplos fictícios, fora da produção, e com um profissional revisando toda saída. Fonte: cartão do modelo maritaca-ai/S5-nano no Hugging Face, atualizado em 06/11.
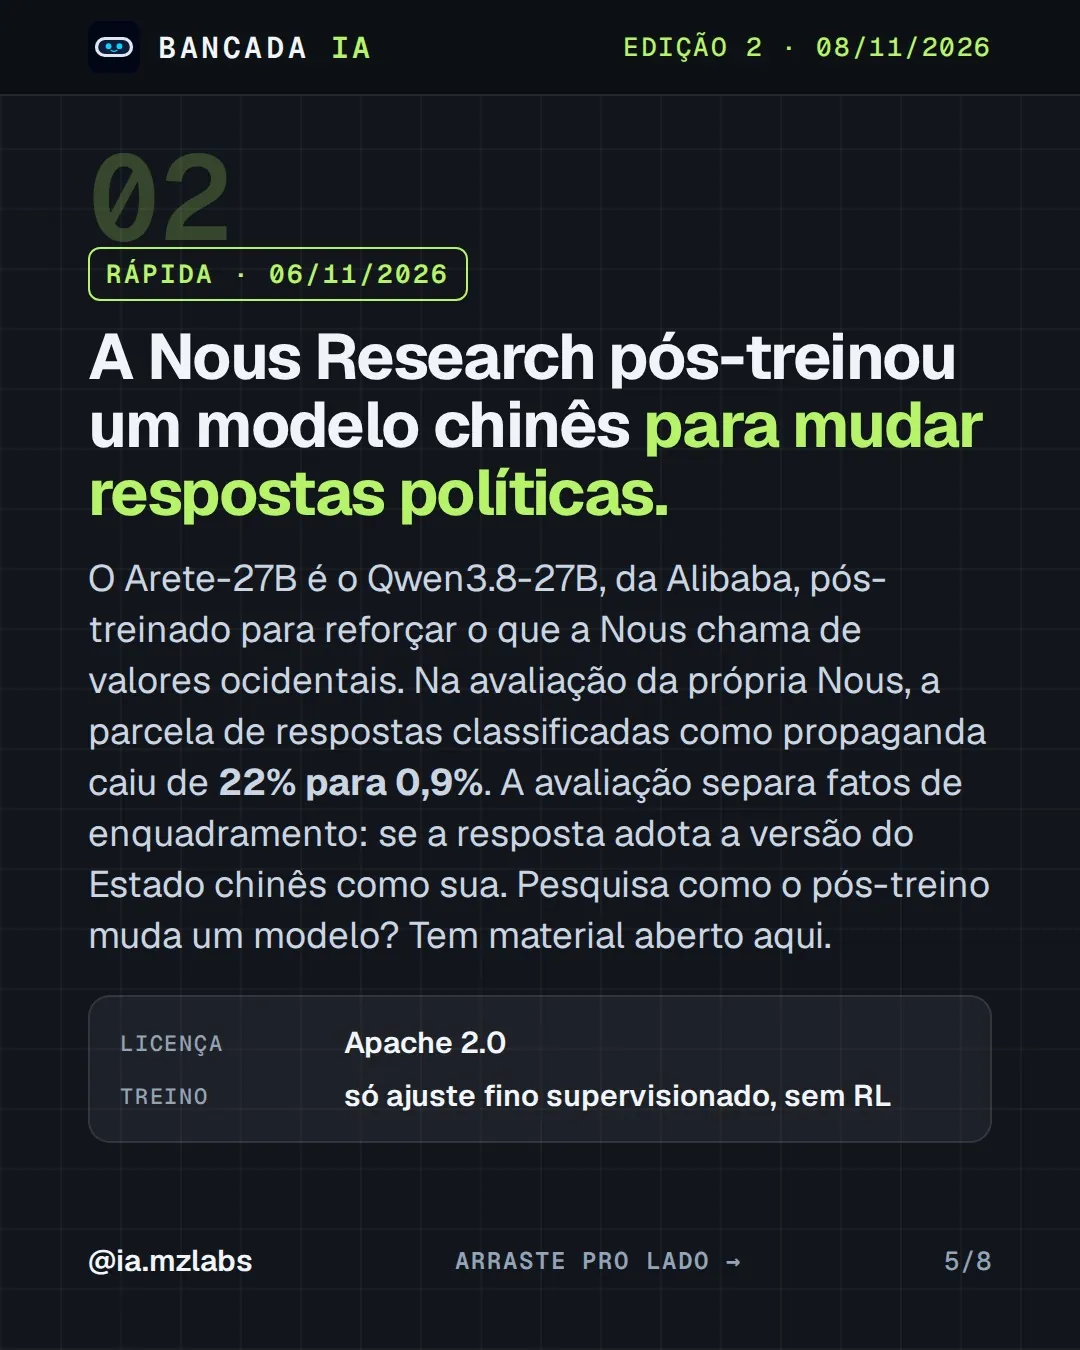
Arete-27B: a Nous Research pós-treinou o Qwen3.8-27B, da Alibaba, para reforçar o que chama de valores ocidentais. Na avaliação da própria Nous, a parcela de respostas classificadas como propaganda caiu de 22% para 0,9%. A avaliação separa fatos de enquadramento: se a resposta adota a versão do Estado chinês como sua. Fonte: cartão do modelo no Hugging Face, 06/11.
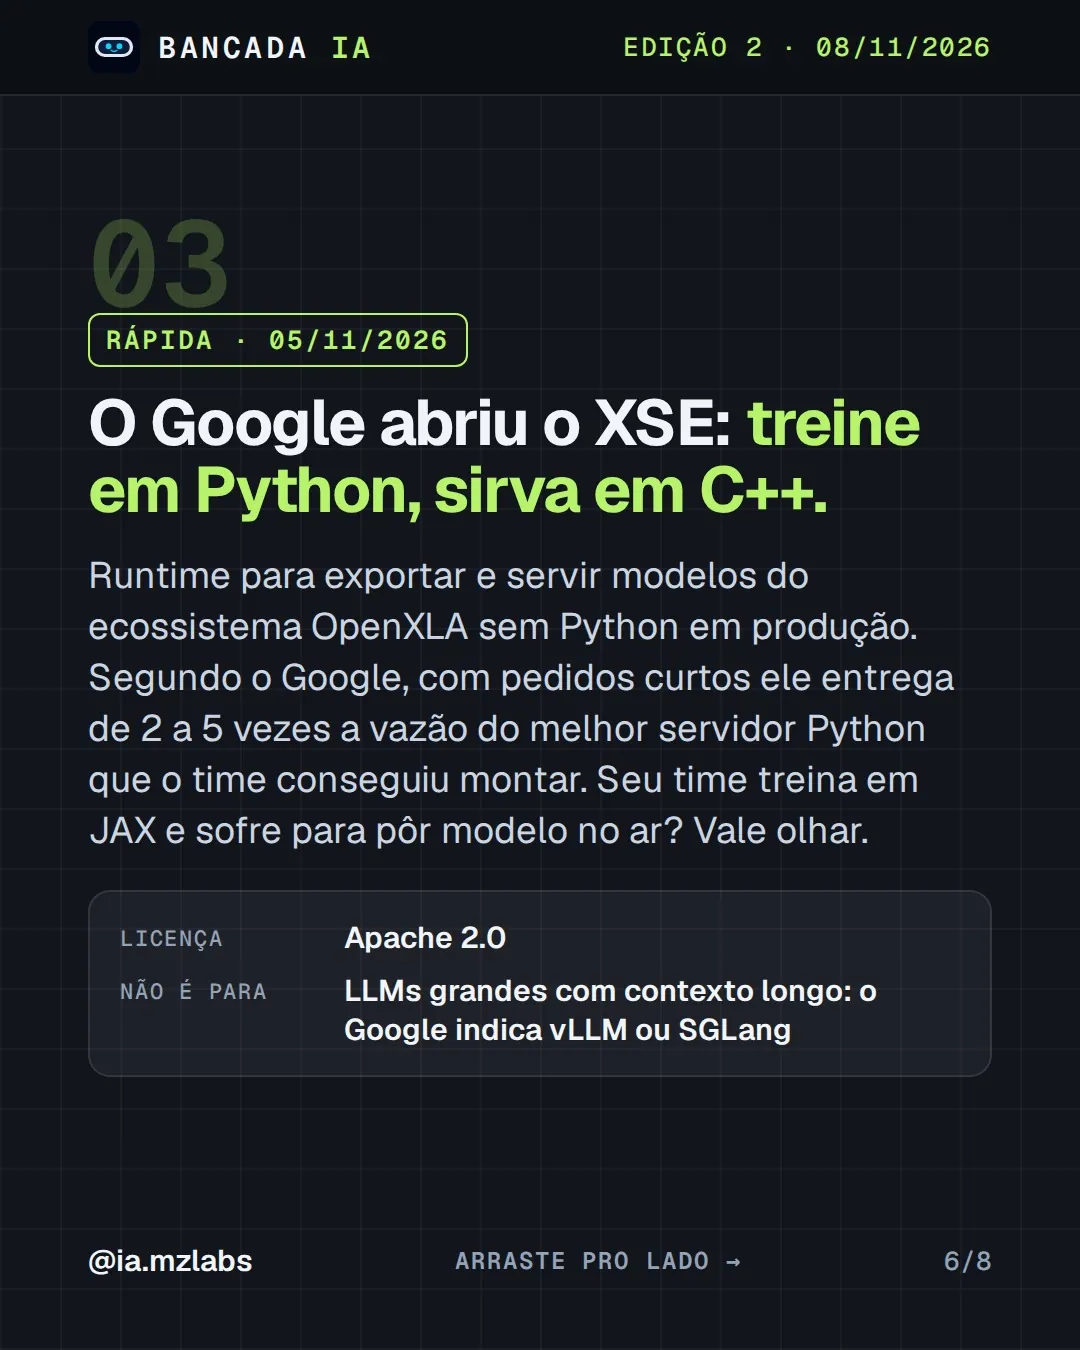
XLA Serving Engine: o Google abriu o código, em Apache 2.0, de um runtime para treinar em Python e servir em C++. Fonte: Google Open Source Blog, 05/11.
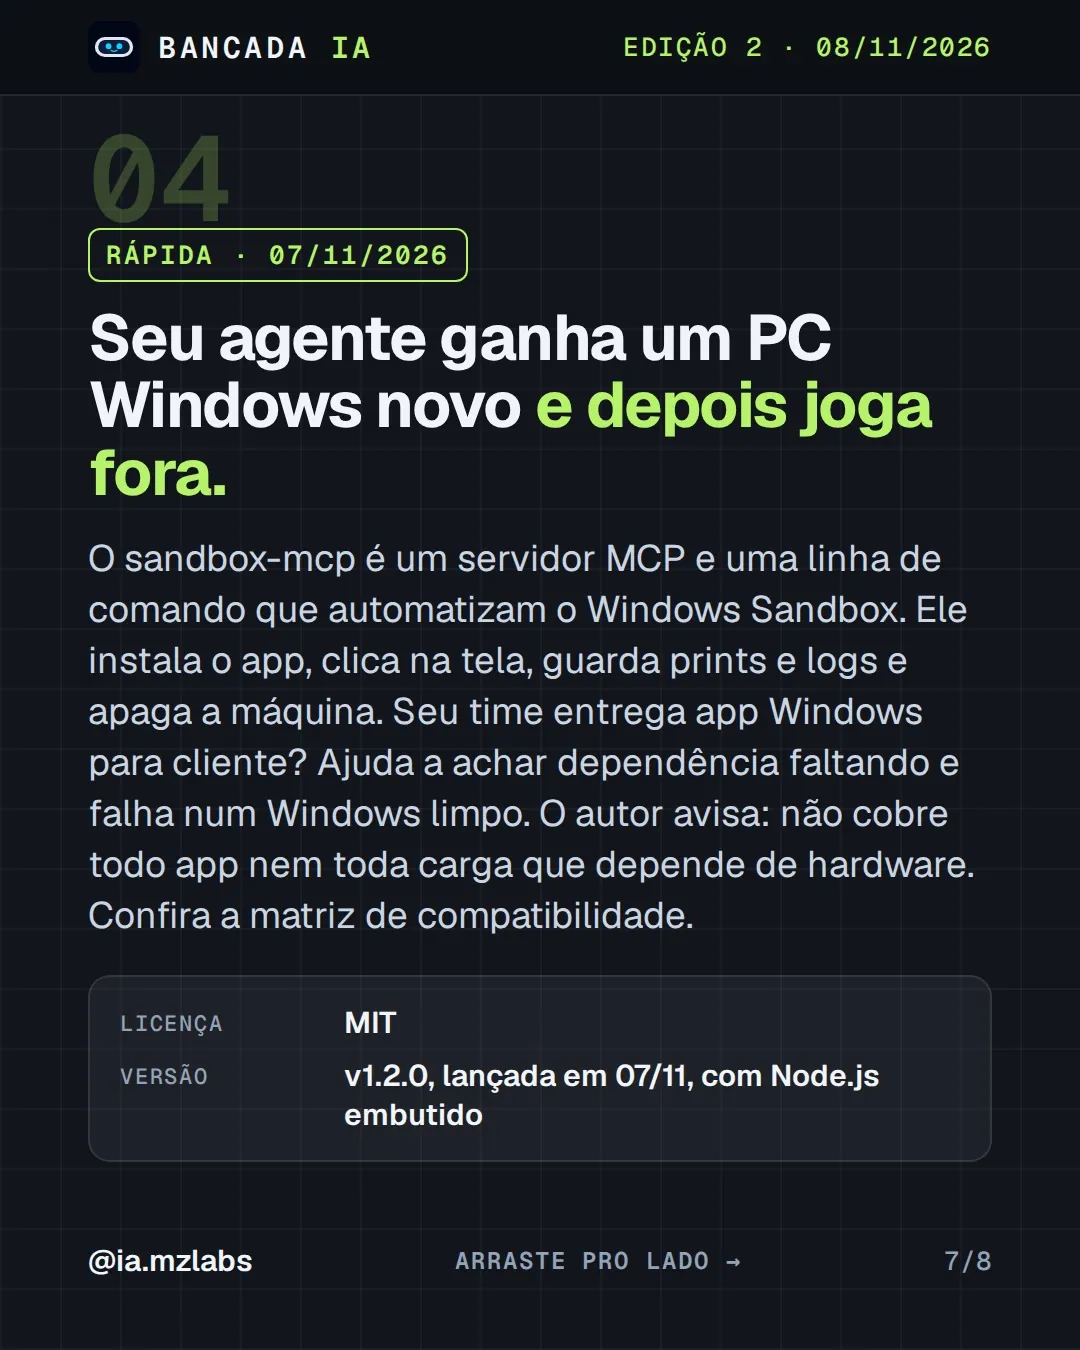
sandbox-mcp: servidor MCP e linha de comando que automatizam o Windows Sandbox para testar apps numa máquina Windows 11 descartável. Fonte: repositório shanselman/sandbox-mcp no GitHub, versão v1.2.0 de 07/11.
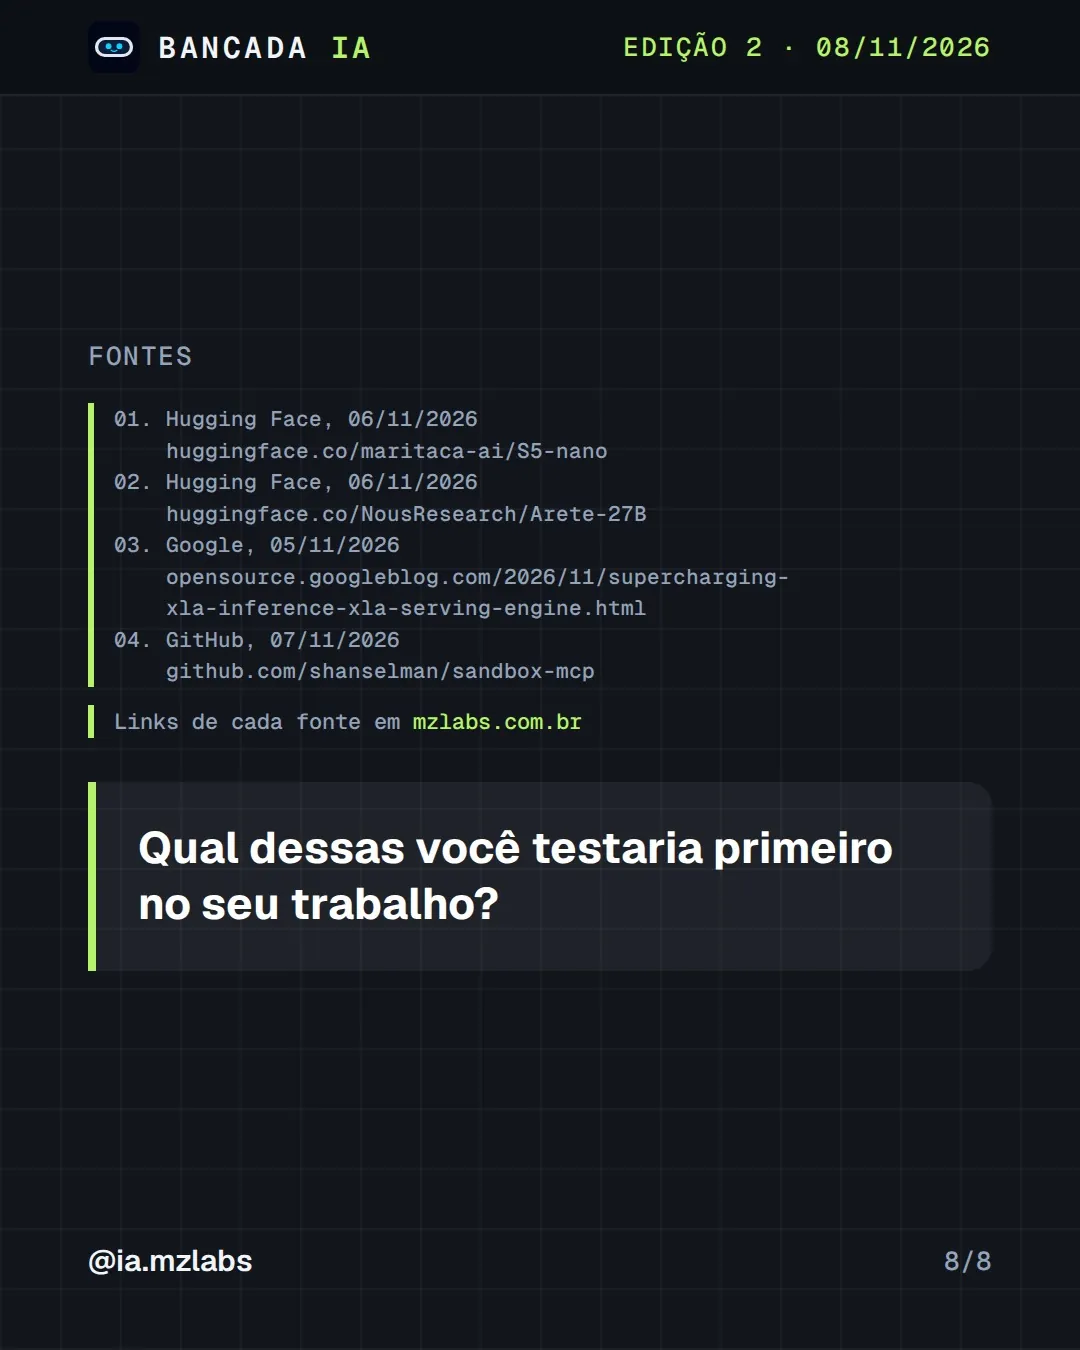
Fontes com link no blog: mzlabs.com.br (link na bio).
Qual dessas você testaria primeiro no seu trabalho?
As telas em texto
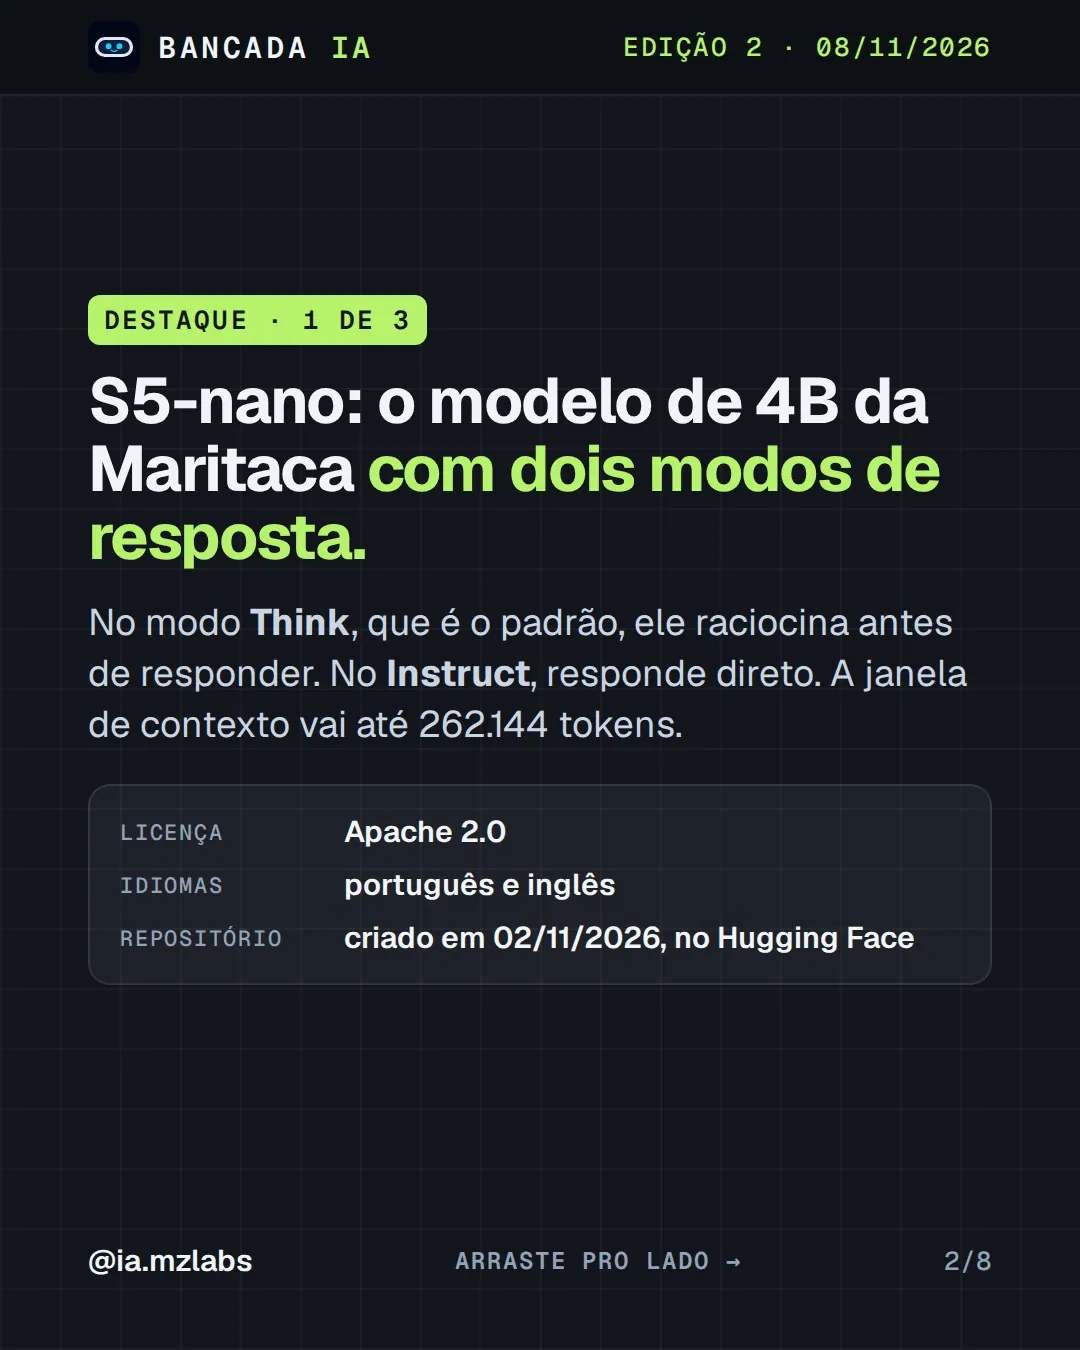
S5-nano: o modelo de 4B da Maritaca com dois modos de resposta.
No modo Think, que é o padrão, ele raciocina antes de responder. No Instruct, responde direto. A janela de contexto vai até 262.144 tokens.
- Licença
- Apache 2.0
- Idiomas
- português e inglês
- Repositório
- criado em 02/11/2026, no Hugging Face
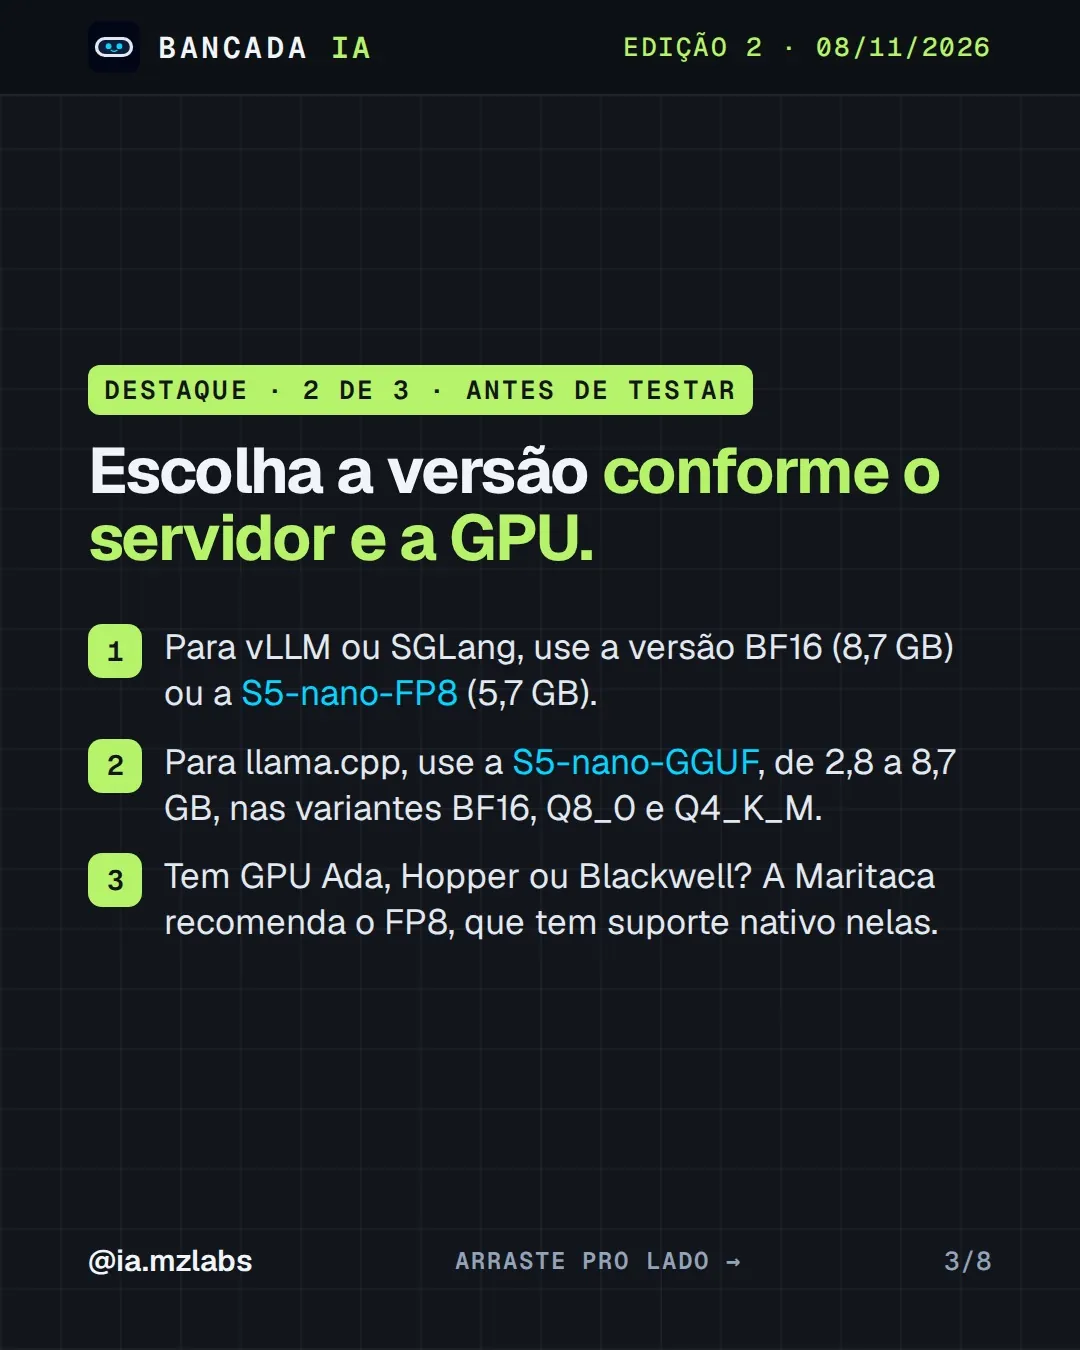
Escolha a versão conforme o servidor e a GPU.
- 1Para vLLM ou SGLang, use a versão BF16 (8,7 GB) ou a S5-nano-FP8 (5,7 GB).
- 2Para llama.cpp, use a S5-nano-GGUF, de 2,8 a 8,7 GB, nas variantes BF16, Q8_0 e Q4_K_M.
- 3Tem GPU Ada, Hopper ou Blackwell? A Maritaca recomenda o FP8, que tem suporte nativo nelas.
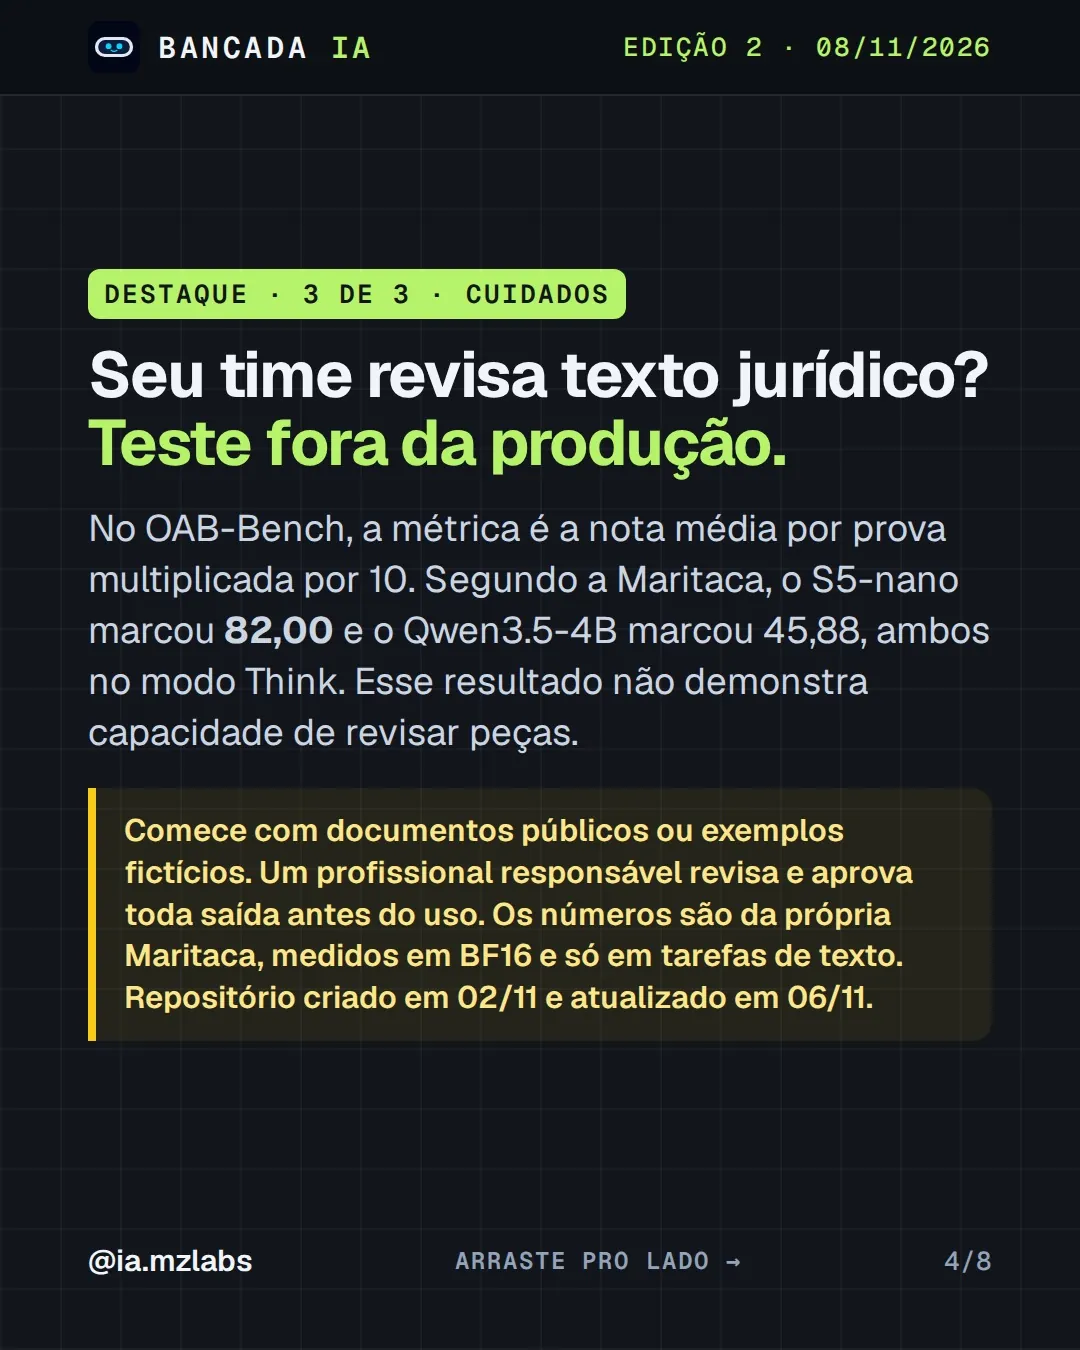
Seu time revisa texto jurídico? Teste fora da produção.
No OAB-Bench, a métrica é a nota média por prova multiplicada por 10. Segundo a Maritaca, o S5-nano marcou 82,00 e o Qwen3.5-4B marcou 45,88, ambos no modo Think. Esse resultado não demonstra capacidade de revisar peças.
A Nous Research pós-treinou um modelo chinês para mudar respostas políticas.
O Arete-27B é o Qwen3.8-27B, da Alibaba, pós-treinado para reforçar o que a Nous chama de valores ocidentais. Na avaliação da própria Nous, a parcela de respostas classificadas como propaganda caiu de 22% para 0,9%. A avaliação separa fatos de enquadramento: se a resposta adota a versão do Estado chinês como sua. Pesquisa como o pós-treino muda um modelo? Tem material aberto aqui.
- Licença
- Apache 2.0
- Treino
- só ajuste fino supervisionado, sem RL
O Google abriu o XSE: treine em Python, sirva em C++.
Runtime para exportar e servir modelos do ecossistema OpenXLA sem Python em produção. Segundo o Google, com pedidos curtos ele entrega de 2 a 5 vezes a vazão do melhor servidor Python que o time conseguiu montar. Seu time treina em JAX e sofre para pôr modelo no ar? Vale olhar.
- Licença
- Apache 2.0
- Não é para
- LLMs grandes com contexto longo: o Google indica vLLM ou SGLang
Seu agente ganha um PC Windows novo e depois joga fora.
O sandbox-mcp é um servidor MCP e uma linha de comando que automatizam o Windows Sandbox. Ele instala o app, clica na tela, guarda prints e logs e apaga a máquina. Seu time entrega app Windows para cliente? Ajuda a achar dependência faltando e falha num Windows limpo. O autor avisa: não cobre todo app nem toda carga que depende de hardware. Confira a matriz de compatibilidade.
- Licença
- MIT
- Versão
- v1.2.0, lançada em 07/11, com Node.js embutido
Fontes
- huggingface.co/maritaca-ai/S5-nano (06/11/2026)
- huggingface.co/NousResearch/Arete-27B (06/11/2026)
- opensource.googleblog.com/2026/11/supercharging-xla-inference-xla-s... (05/11/2026)
- github.com/shanselman/sandbox-mcp (07/11/2026)